Tracking server-side: cos'è e perché serve davvero
Perché i numeri di Meta, Google e del gestionale non tornano, cosa cambia spostando il tracciamento sul server e da dove iniziare senza rifare tutto.
Apri Gestione inserzioni e vedi 120 acquisti. Apri Google Analytics e ne conti 84. Il gestionale, quello che fa fede per il commercialista, dice 140. Tre numeri, tre verità, nessuna decisione presa con serenità. Se ti riconosci, il problema non è nelle campagne: è in come raccogli il dato. E la soluzione, nella maggior parte dei casi, si chiama tracking server-side.
Cos'è il tracking server-side, in due righe
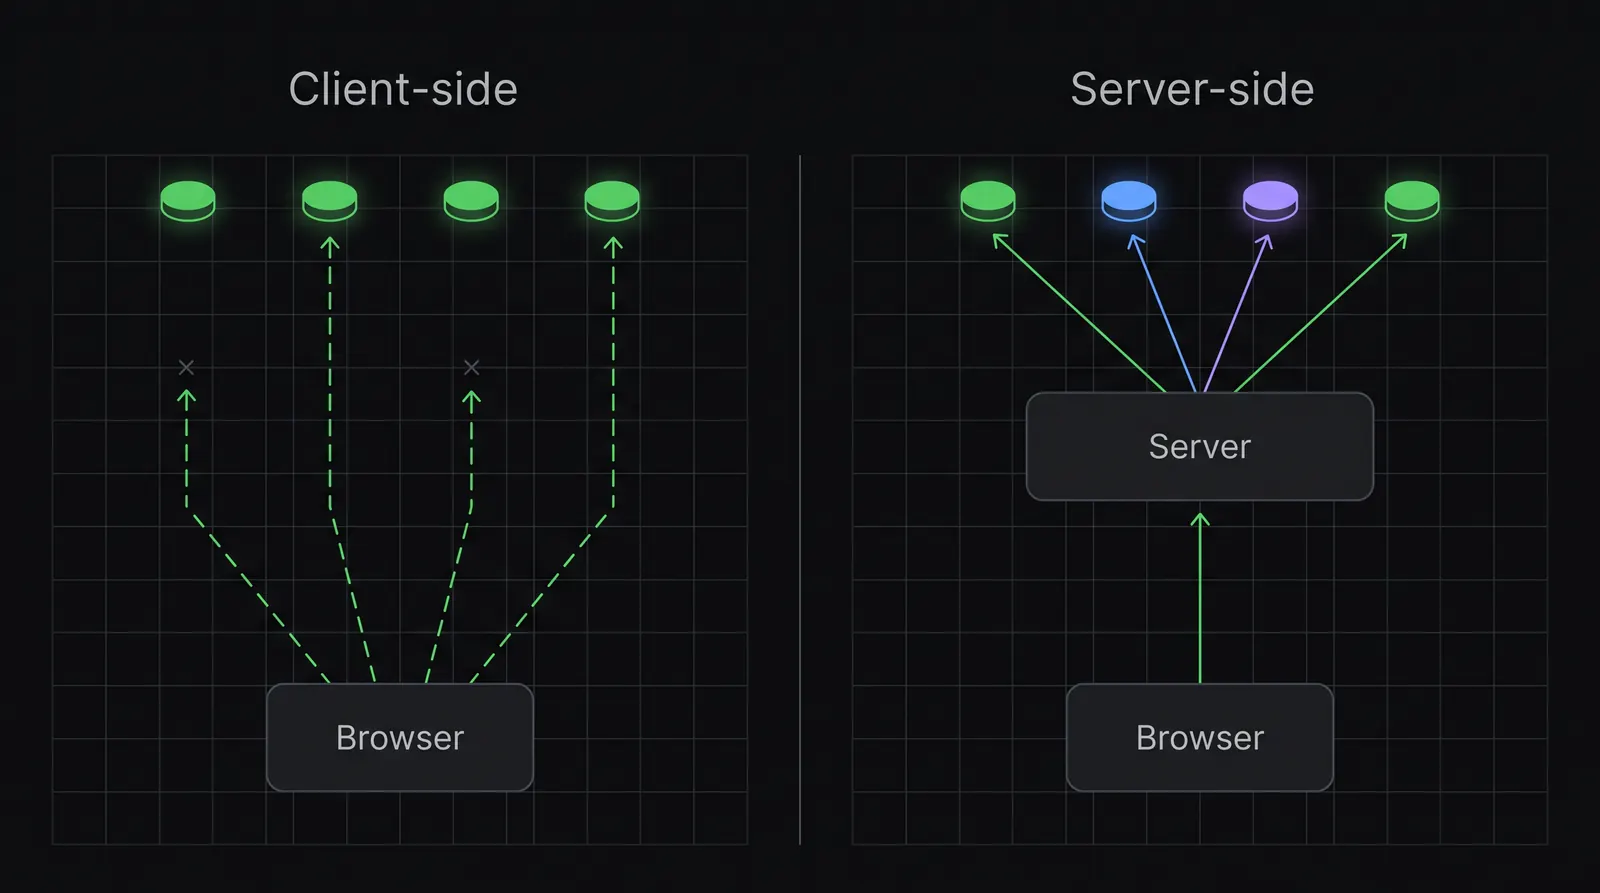
Nel tracking tradizionale (client-side) il browser dell'utente fa tutto il lavoro: carica il Pixel di Meta, il tag di Google, lo script di analytics, e manda a ciascuna piattaforma un segnale ogni volta che succede qualcosa. Il tuo sito, in pratica, delega la misurazione a decine di script di terze parti che girano sul dispositivo di uno sconosciuto.
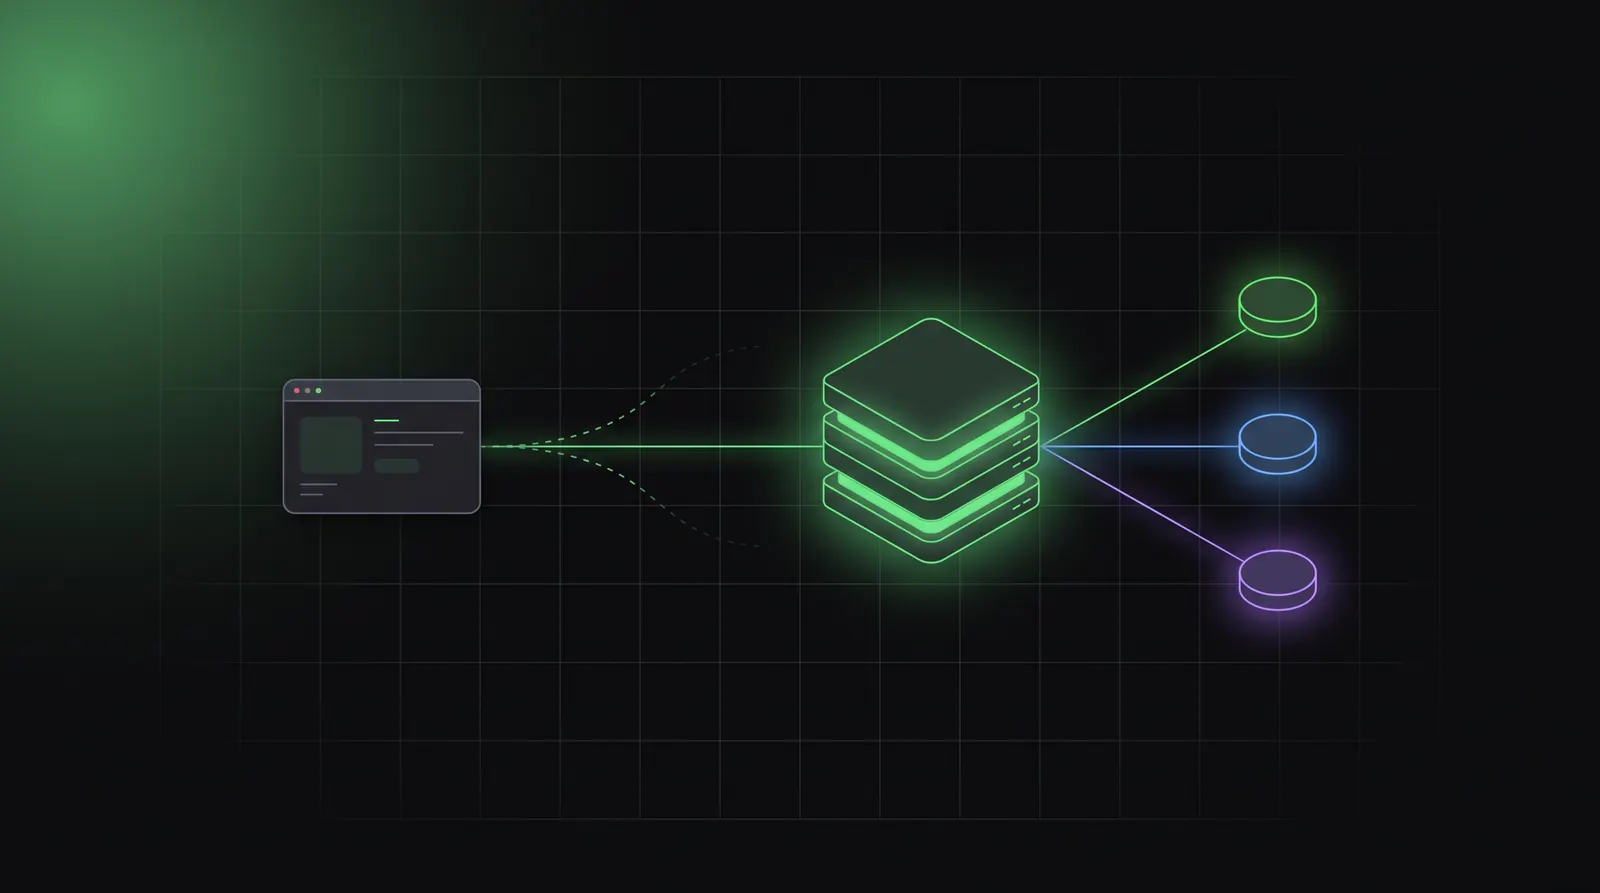
Nel tracking server-side il browser manda un solo segnale a un server che controlli tu. È quel server che poi parla con Meta, Google, GA4, il CRM e il data warehouse. Il dato nasce in casa tua, viene arricchito e normalizzato, e solo dopo viene distribuito a chi ne ha bisogno.
La differenza sembra tecnica. In realtà cambia chi è il padrone del dato.
Perché il tracking lato browser perde pezzi
Non è una questione di configurazione sbagliata. Il tracking client-side è strutturalmente fragile per almeno cinque ragioni.
- Ad blocker e protezioni del browser. Una parte del tuo traffico blocca gli script di tracciamento prima ancora che si carichino. Per quelle visite, la piattaforma pubblicitaria non vede nulla: né il clic che ha portato l'utente, né l'acquisto.
- Limiti ai cookie di Safari e Firefox. Safari, con Intelligent Tracking Prevention, taglia a sette giorni (in alcuni casi a 24 ore) la durata dei cookie impostati via JavaScript. Un cliente che clicca oggi e compra tra dieci giorni, per il Pixel è un cliente arrivato dal nulla.
- iOS e il consenso al tracciamento. Dal 2021, su iPhone, l'app di Facebook e Instagram deve chiedere il permesso prima di seguire l'utente fuori dall'app. Molti dicono di no. Il collegamento tra annuncio e acquisto si spezza.
- Connessioni e dispositivi lenti. Se l'utente chiude la pagina di ringraziamento prima che lo script sia partito, l'evento non esiste. Succede più spesso di quanto pensi su mobile.
- Caos di tag. Dieci script indipendenti, ognuno con la propria logica, mandano eventi leggermente diversi. Nessuno mente, nessuno dice la stessa cosa.
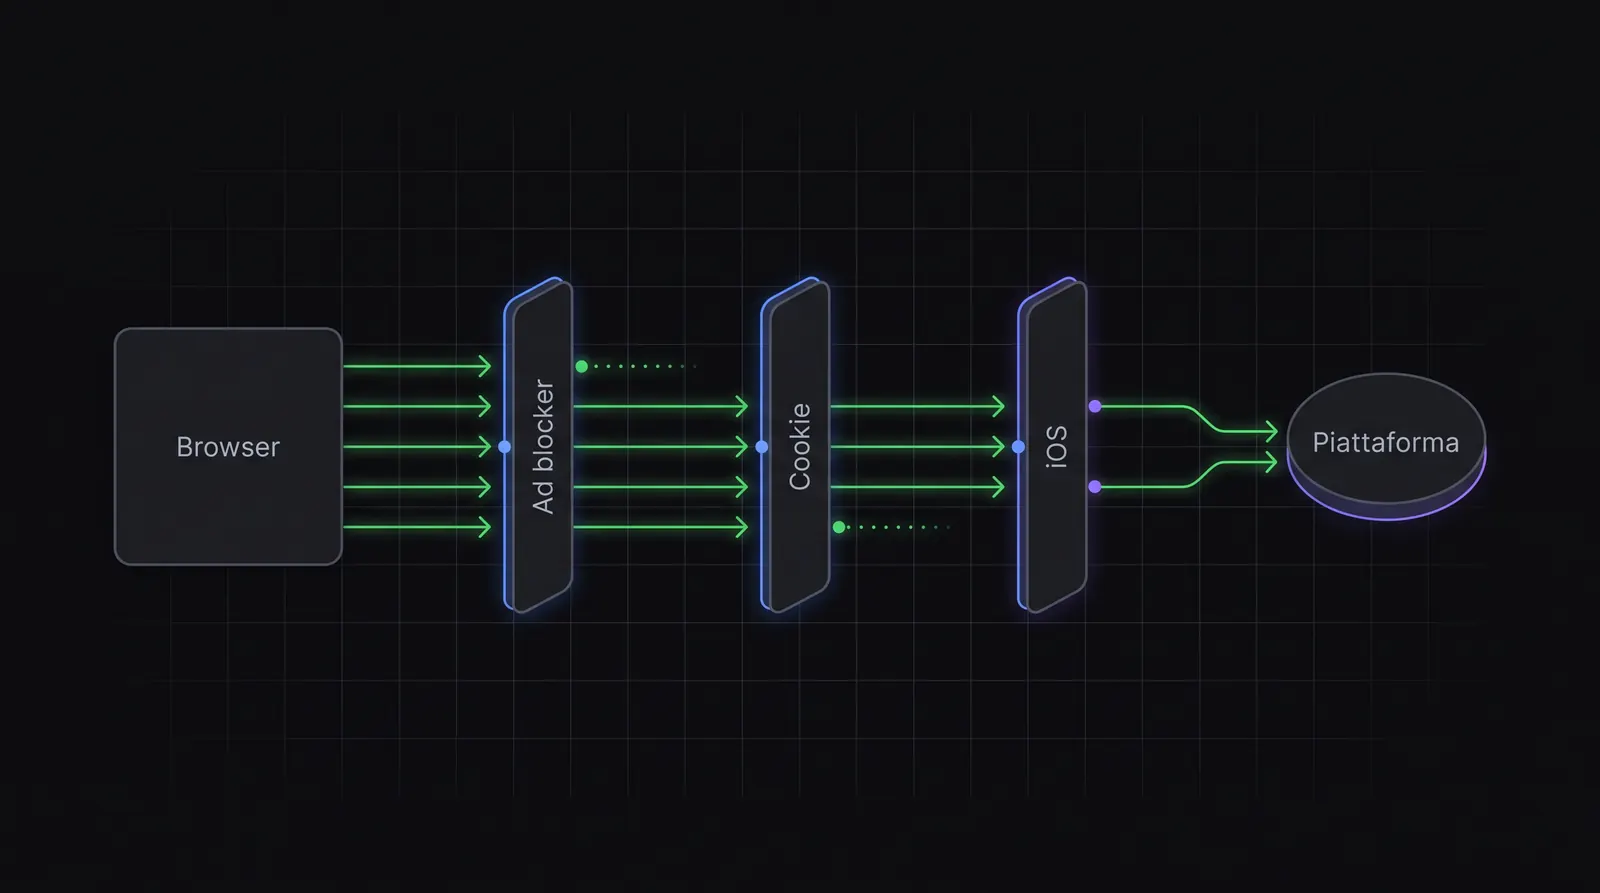
Il risultato è un'attribuzione a macchie di leopardo: le piattaforme ottimizzano su dati parziali e tu prendi decisioni di budget su numeri che sottostimano sistematicamente alcuni canali.
Come funziona in pratica
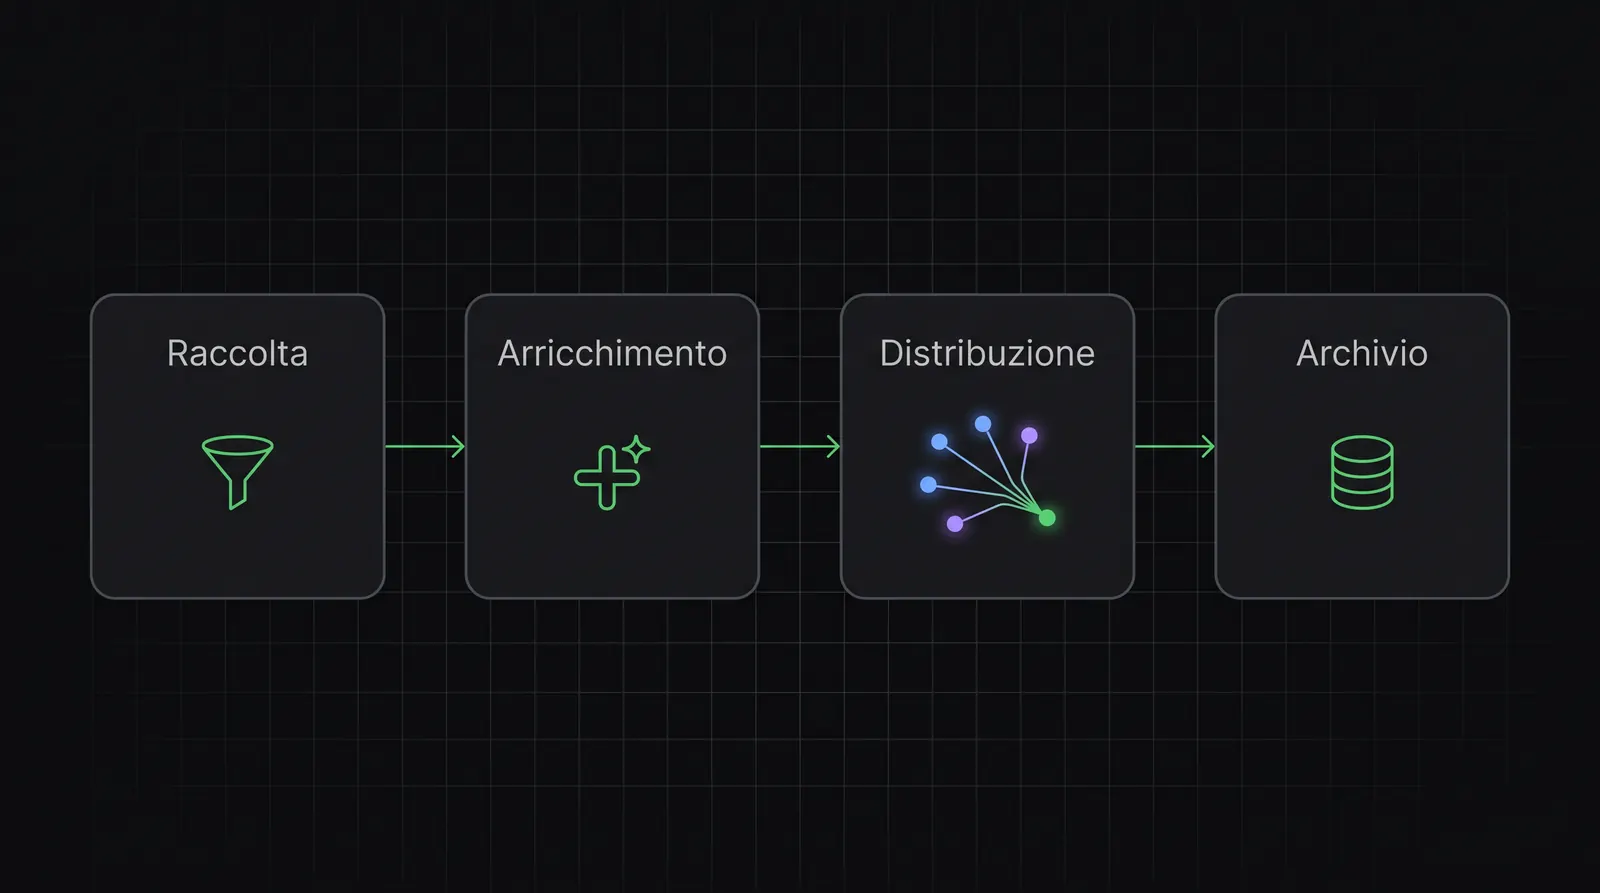
Un'infrastruttura di tracking server-side ben fatta ha quattro pezzi.
1. Un punto di raccolta unico
Sul sito resta un solo tag leggero, servito dal tuo dominio. Raccoglie gli eventi (visita, visualizzazione prodotto, lead, acquisto) e li manda a un endpoint che gestisci tu, ad esempio un container di tagging lato server. Essendo di prima parte, i suoi cookie non subiscono i limiti riservati alle terze parti.
2. Un livello di arricchimento
Qui il dato diventa buono. Si aggiungono i parametri che le piattaforme usano per riconoscere l'utente (identificativi di clic, email e telefono in forma hash, indirizzo IP, user agent), si assegna un identificativo univoco a ogni evento, si normalizzano i valori. È lo stesso principio alla base della Meta Conversion API e delle conversioni avanzate di Google.
3. La distribuzione alle piattaforme
Il server invia ogni evento a Meta, Google Ads, GA4, TikTok e a chiunque altro serva, con lo stesso identificativo. Se il Pixel lato browser ha già mandato quell'evento, la piattaforma lo riconosce come duplicato e lo scarta. Niente doppi conteggi.
4. La copia che resta a te
Lo stesso flusso scrive gli eventi in un data warehouse come BigQuery. È la base per una dashboard di Business Intelligence che non dipende da nessuna piattaforma e per collegare il marketing al CRM e al venduto reale.
Client-side e server-side a confronto
| Aspetto | Solo browser | Server-side |
|---|---|---|
| Resistenza ad ad blocker | Bassa | Alta: il tag è di prima parte |
| Durata dei cookie su Safari | Fino a 7 giorni | Impostati lato server, durata piena |
| Qualità del match con le piattaforme | Dipende dal cookie | Arricchita con dati hash di prima parte |
| Controllo su cosa viene inviato | Nessuno: ogni script decide da sé | Totale: un solo punto di uscita |
| Velocità del sito | Decine di script | Un tag leggero |
| Proprietà del dato | Delle piattaforme | Tua, nel tuo warehouse |
| Complessità iniziale | Bassa | Media: serve progettazione |
Cosa cambia per la tua azienda
Il beneficio più immediato è che le piattaforme pubblicitarie ricevono più conversioni, e più complete. Nei nostri progetti, passare a un'architettura server-side ha recuperato in media il 40% di conversioni che prima non venivano attribuite a nessun canale. Non sono vendite in più: sono vendite che già facevi, finalmente collegate alla campagna che le ha generate.
Da lì derivano effetti a catena:
- Gli algoritmi ottimizzano meglio. Meta e Google imparano da ciò che vedono. Se vedono il doppio delle conversioni reali, trovano clienti simili con più precisione e il costo per acquisizione tende a scendere.
- Il budget va dove serve. Canali che sembravano in perdita, come le campagne di remarketing su Safari, tornano in utile semplicemente perché finalmente vengono misurati.
- Un numero solo per tutti. Marketing, commerciale e direzione guardano la stessa fonte. Finiscono le riunioni passate a discutere di quale report sia quello giusto.
- Il percorso del cliente diventa leggibile. Con eventi coerenti e identificativi persistenti puoi ricostruire il percorso dal primo clic al pagamento, anche a distanza di settimane.
Quello che il server-side non fa
Vale la pena essere chiari, perché il tema è pieno di promesse eccessive.
- Non aggira il consenso. Se l'utente rifiuta i cookie di marketing, il dato non va inviato alle piattaforme pubblicitarie. Il server-side rende il consenso più semplice da rispettare, perché c'è un solo punto in cui applicarlo, non un modo per ignorarlo.
- Non ripara eventi definiti male. Se "lead" significa tre cose diverse per tre persone in azienda, spostare il problema sul server non lo risolve. Prima si definisce cosa misurare, poi lo si misura.
- Non è un prodotto da installare e dimenticare. Le piattaforme cambiano i parametri, i siti cambiano le pagine. Serve un monitoraggio dell'affidabilità del dato nel tempo.
Da dove iniziare
Se oggi hai solo il Pixel e il tag di Google installati dal sito, non devi buttare via nulla. Il percorso che seguiamo di solito è questo.
- Mappa degli eventi. Elenca le azioni che contano per il business (non quelle che il tema del sito traccia di default) e definisci per ciascuna nome, parametri e valore economico.
- Audit del tracciamento attuale. Confronta per due settimane i numeri di piattaforme, analytics e gestionale. La differenza è la dimensione del problema, e il tuo punto di partenza per misurare il miglioramento.
- Infrastruttura server-side. Container di tagging sul tuo dominio, collegamenti a Meta, Google e GA4 con deduplicazione, scrittura su BigQuery. Nei nostri progetti questa fase, dashboard compresa, richiede circa 14 giorni.
- Verifica e monitoraggio. Test degli eventi in tempo reale, controllo della qualità del match, alert automatici quando un evento smette di arrivare.
Il quadro completo di come strutturiamo questo lavoro è nella pagina sul framework di tracking server-side, con il dettaglio del livello dedicato alle conversioni. Se preferisci partire dai tuoi numeri, prenota una call: in trenta minuti confrontiamo le tue fonti e ti diciamo quanto stai perdendo per strada.